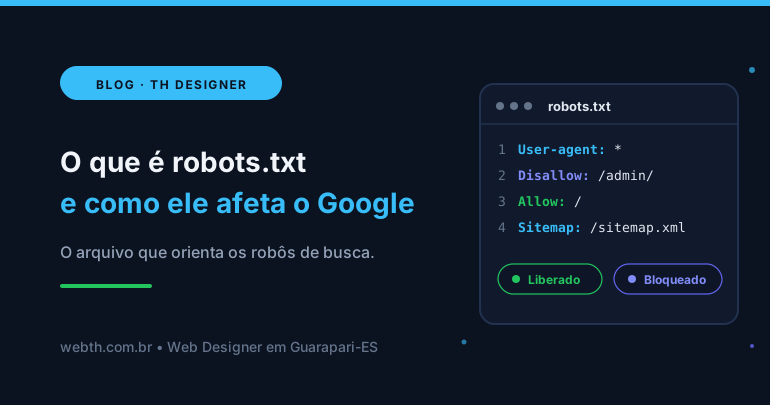
O site novo ficou pronto, foi ao ar e, um mês depois, não aparece no Google nem quando alguém digita o nome exato da empresa. Antes de culpar a concorrência ou o algoritmo, vale olhar um arquivo pequeno que quase ninguém abre: o robots.txt. Uma única linha esquecida nele pode pedir ao Google que ignore o site inteiro.
Veja o que é o robots.txt, para que ele serve e como conferir o seu em poucos minutos, sem saber programar. Se o seu problema é o site sumido da busca, leia também por que meu site não aparece no Google.
O que é robots.txt
O robots.txt é um arquivo de texto simples que fica na raiz do site, sempre no mesmo endereço: seusite.com.br/robots.txt. Ele traz instruções para os robôs de busca, os programas que o Google e outras empresas usam para visitar e ler as páginas da internet.
Pense na portaria de um prédio comercial. Na entrada há uma placa: "Entregas só no térreo. Proibido subir ao 3º andar". O entregador educado obedece. Quem chega com más intenções ignora a placa. O robots.txt funciona do mesmo jeito: os robôs do Google, do Bing e de outras empresas sérias respeitam as regras, mas o arquivo não tranca porta nenhuma.
Ele também é público. Qualquer pessoa pode digitar o endereço de um site seguido de /robots.txt e ler o que está escrito. Faça o teste agora com o seu.
Como os robôs do Google leem o arquivo
Antes de visitar as páginas de um site, o robô do Google, chamado Googlebot, procura o robots.txt. Se o arquivo libera o caminho, ele segue em frente, lê as páginas e as envia para o índice do Google, o grande catálogo de onde saem os resultados da busca. Se o arquivo bloqueia um caminho, o robô pula aquela parte.
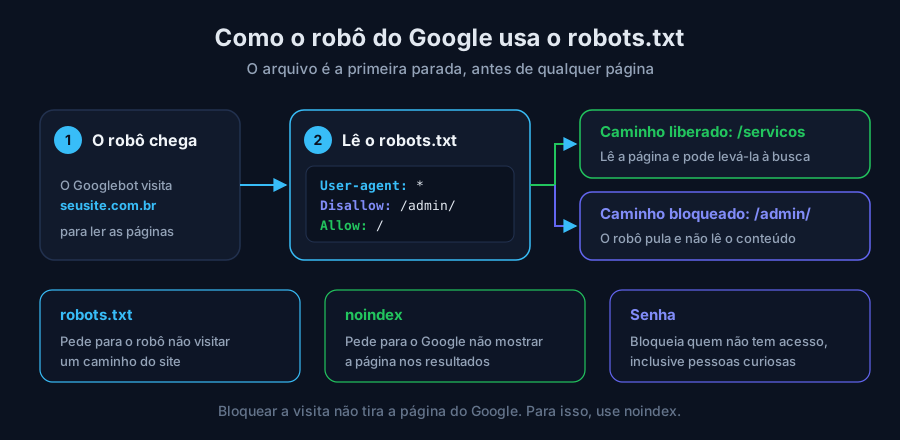
Um robots.txt comum tem poucas linhas, e cada uma tem um papel:
- User-agent: diz para qual robô vale a regra. O asterisco (*) significa "todos os robôs".
- Disallow: indica o caminho que o robô não deve visitar, como /admin/ ou /carrinho/.
- Allow: libera um caminho específico, mesmo dentro de uma área bloqueada.
- Sitemap: informa o endereço do sitemap, a lista de páginas que você quer que o Google conheça.
Se o site não tiver robots.txt, o Google entende que pode visitar tudo. Para muitos sites pequenos, isso não causa problema. O risco maior está no arquivo mal configurado.
Para que serve o robots.txt no site de uma empresa
Num site institucional pequeno, o arquivo tem duas ou três linhas. Ele ganha importância conforme o site cresce:
- Afastar os robôs de áreas internas. O painel administrativo, as telas de login e o carrinho de compras não precisam ser lidos pelo Google.
- Evitar endereços repetidos na loja virtual. Filtros de cor, tamanho e preço podem gerar centenas de endereços com os mesmos produtos. Bloquear esses caminhos poupa o tempo do robô para as páginas que importam e reduz o risco de conteúdo duplicado.
- Deixar a busca interna de fora. As páginas de resultado da pesquisa do próprio site não ajudam ninguém no Google e podem ser bloqueadas.
- Apontar o sitemap. A linha Sitemap ajuda os buscadores a achar a lista completa de páginas mais rápido.
Robots.txt, noindex e senha: qual a diferença
Este é o ponto que mais confunde. O robots.txt pede ao robô para não visitar uma página, mas não garante que ela fique fora do Google. Se outros sites tiverem links para essa página, o Google pode mostrar o endereço nos resultados mesmo sem ter lido o conteúdo, normalmente sem descrição.
Para tirar uma página dos resultados, o caminho certo é a etiqueta noindex, um aviso colocado no código da própria página. Para proteger uma informação de verdade, só senha resolve. A tabela compara as três opções:
| Ponto | robots.txt | noindex | Senha |
|---|---|---|---|
| O que faz | Pede para o robô não visitar um caminho | Pede para o Google não mostrar a página na busca | Bloqueia o acesso de quem não tem login |
| Tira a página do Google? | Não garante | Sim, depois que o robô volta a ler a página | Sim, porque ninguém de fora lê o conteúdo |
| Protege informação? | Não, e o arquivo é público | Não, a página continua aberta | Sim |
| Onde fica | Um arquivo só, na raiz do site | No código de cada página | No servidor ou no sistema do site |
| Bom para | Áreas internas, filtros e busca interna | Página de obrigado, testes e conteúdo antigo | Área do cliente, ambiente de testes e documentos |
Um cuidado importante: não use robots.txt e noindex juntos na mesma página. Se o robots.txt bloqueia a visita, o Google nunca chega a ler o noindex, e a página pode continuar aparecendo na busca. É o caso típico da página de obrigado: ela deve ficar liberada no robots.txt e marcada com noindex.
Erros comuns que tiram o site do Google
- Esquecer o bloqueio da fase de testes. Enquanto o site está em construção, é comum bloquear tudo com a linha "Disallow: /". Se ninguém apagar essa linha na publicação, o site novo vai ao ar invisível para o Google. Por isso ela aparece no checklist antes de publicar o site.
- Deixar marcada a caixinha do WordPress. No WordPress, as configurações de leitura têm uma opção que pede aos buscadores para não indexar o site. Ela costuma ser ligada durante a construção e esquecida depois, com efeito parecido.
- Bloquear os arquivos de visual. Alguns robots.txt antigos bloqueiam as pastas de estilo e de scripts. Sem elas, o Google enxerga uma página quebrada e pode concluir que o site funciona mal no celular.
- Usar o arquivo como esconderijo. Escrever "Disallow: /documentos-internos/" mostra a qualquer curioso onde procurar. Informação sensível precisa de senha.
- Esquecer os subdomínios. Cada subdomínio tem o próprio robots.txt. O arquivo de seusite.com.br não vale para loja.seusite.com.br.
- Errar uma letra. As regras diferenciam maiúsculas de minúsculas. Bloquear /Fotos/ não bloqueia /fotos/, e uma barra a mais ou a menos muda o resultado.
- Trocar de site sem revisar. Ao migrar de hospedagem ou de plataforma, o robots.txt antigo pode ser trocado por um padrão que não combina com o site novo.
E os robôs de inteligência artificial?
As ferramentas de IA também usam robôs para ler sites, e muitos deles respeitam o robots.txt. O GPTBot, da OpenAI, é um exemplo. Algumas empresas bloqueiam esses robôs para que o conteúdo não seja usado por eles.
Para um negócio local que quer ser recomendado, bloquear tudo pode sair caro: se a IA não lê o seu site, fica mais difícil ela citar a sua empresa. Veja como se preparar em como aparecer nas respostas de IA.
Como conferir o robots.txt do seu site
- Abra o arquivo. Digite no navegador o endereço do site seguido de /robots.txt. Se aparecer uma página de erro, o site não tem o arquivo, o que não impede o Google de entrar.
- Procure a linha perigosa. Um "Disallow: /" sozinho, logo abaixo de "User-agent: *", bloqueia o site inteiro para todos os robôs. Se encontrar isso num site que já está no ar, avise quem cuida dele no mesmo dia.
- Confira o sitemap. Veja se a linha Sitemap aponta para um endereço que abre de verdade.
- Use o Search Console. No Google Search Console, o relatório de robots.txt, dentro das configurações, mostra a versão que o Google leu e se houve erro. A inspeção de URL diz se uma página específica está bloqueada.
- Tenha paciência depois de corrigir. O Google costuma guardar uma cópia do arquivo por até um dia. Depois disso, as páginas voltam a ser visitadas aos poucos, e pedir a indexação das principais no Search Console ajuda a acelerar.
Um exemplo aqui de Guarapari
Imagine uma clínica de fisioterapia em Guarapari que trocou o site antigo por um novo, mais bonito e mais rápido. A versão nova foi montada num endereço de testes, com o robots.txt bloqueando tudo, como deve ser nessa fase. No dia da publicação, os arquivos foram copiados para o endereço oficial, e o bloqueio veio junto.
Nas semanas seguintes, a página de pilates, que aparecia bem para quem buscava "pilates em Guarapari", perdeu posições até sumir. No Search Console, as páginas estavam marcadas como bloqueadas pelo robots.txt. A correção levou cinco minutos: apagar uma linha, reenviar o sitemap e pedir a indexação das páginas principais. As posições voltaram aos poucos, mas o mês de agenda vazia não volta.
Na maioria dos sites de pequenas empresas, o robots.txt certo é curto e quase não muda. O problema é que ninguém olha para ele até as visitas caírem. A TH Designer entrega cada site com o robots.txt, o sitemap e o Search Console configurados e revisados no dia da publicação, para que nada atrapalhe o Google de encontrar o seu negócio. Conheça nossos serviços e chame a gente no WhatsApp.
Comentários
Entre com a sua conta Google para comentar.